Подробный ответ
В этом ответе
Установка Ollama заканчивается раньше, чем появляется ваш первый локальный ИИ. На компьютере уже может быть программа, но ещё не быть модели. А рядом в каталоге могут находиться варианты, которые выполняются в облаке. Именно в этом месте легко решить, что «всё установлено», и остаться без работающего чата после отключения интернета.
Ниже один маршрут до проверяемого результата: скачать программу, получить конкретную локальную модель и задать ей новый вопрос без сети. Основные команды одинаковы на Windows, macOS и Linux. После установки своей ОС можно читать общий путь.
Инструкции и ссылки сверены с документацией 6 ноября 2026 года. Это руководство по официальным источникам; здесь нет заявления о проведённых нами испытаниях всех трёх ОС. Скорость и доступная память зависят от вашего компьютера.
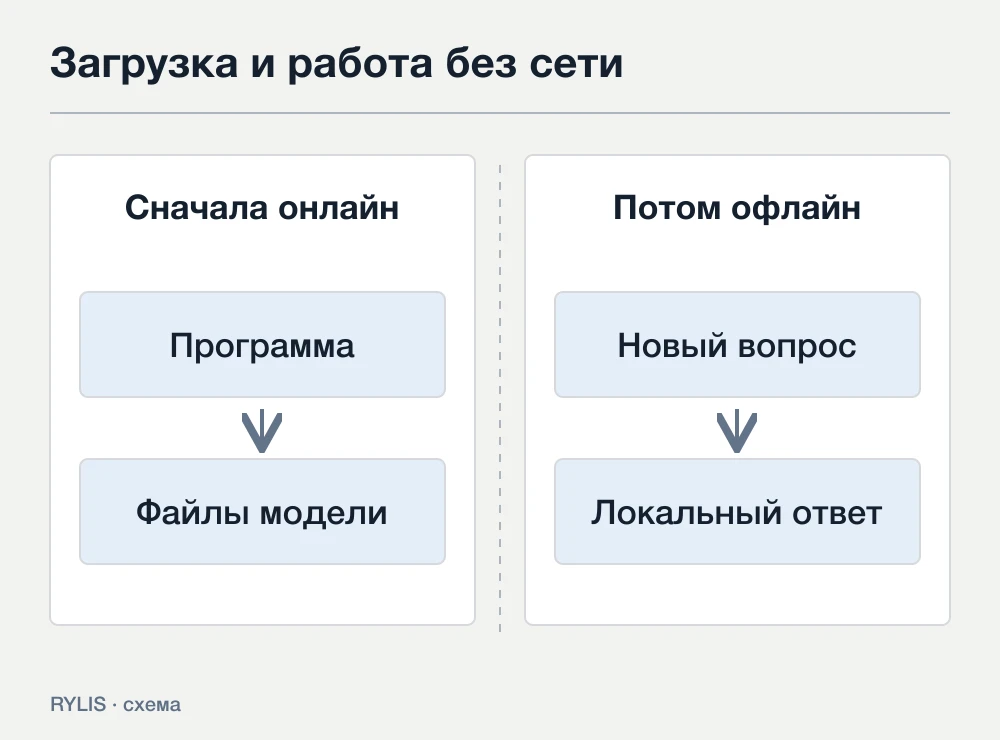
До отключения сети нужны программа и модель
У Ollama две разные роли. Программа запускает вычисление и управляет моделями. Файлы модели содержат параметры, которые нужны для ответа. Установщик приложения не заменяет загрузку весов.
В этом руководстве используем точный тег qwen3:0.6b. На момент проверки карточка модели показывает загрузку около 523 МБ. Такой размер удобен для первой технической проверки. Это небольшая модель с ограниченным качеством; выбор здесь не означает рекомендацию использовать её для сложных или ответственных задач. Тег со временем может обновиться, поэтому перед загрузкой снова посмотрите карточку.
Размер скачивания не равен всей памяти, необходимой при работе. Кроме весов нужны рабочие буферы и контекст диалога. Даже маленький файл не даёт универсальной гарантии совместимости. Сначала проверим короткий текстовый разговор, затем можно подбирать более подходящую модель под вашу задачу.
Если вы ещё выбираете между программами, начните со сравнения Ollama и LM Studio. Если выбор уже сделан, подготовьте свободное место и стабильное соединение для загрузки.
Установите Ollama для своей системы
Windows
Скачайте установщик со страницы Ollama для Windows и запустите его. В документации указана Windows 10 22H2 или новее. После установки откройте приложение Ollama, затем новое окно PowerShell или командной строки.
Команда ollama должна быть доступна в новом терминале. Если старое окно было открыто во время установки, закройте его и откройте снова. Подробности и требования к ускорению находятся в официальной инструкции Windows.
Для первого короткого разговора не начинайте с переустановки драйверов и сложной настройки GPU. Сначала убедитесь, что программа запускается и может загрузить выбранную модель. Если нужна работа конкретного ускорителя, сверяйтесь с поддержкой вашего оборудования отдельно.
macOS
Скачайте Ollama для Mac, откройте DMG и перенесите приложение в Applications. Запустите его и завершите обычные шаги настройки. Если приложение запрашивает создание ссылки для команды ollama, этот шаг нужен для доступа из Terminal.
Документация указывает macOS 14+; Apple Silicon поддерживает CPU/GPU, а Intel x86 работает через CPU. Требования и установка macOS. Большой объём общей памяти у Mac не означает, что весь он доступен модели: систему и другие программы тоже нужно обслуживать.
Linux
Официальная документация предлагает установочный скрипт с домена Ollama. Его можно сначала сохранить в файл, ознакомиться с содержимым и запустить:
curl -fsSL https://ollama.com/install.sh -o ollama-install.sh
sh ollama-install.sh
Особенности архитектуры процессора и аппаратного ускорения приведены в инструкции Linux. Если после установки локальный сервис не работает, откройте отдельный терминал и запустите ollama serve. Оставьте это окно открытым, а следующие команды вводите в другом окне. Если сервис уже работает, второй экземпляр не нужен.
Проверьте команду до скачивания модели
В новом терминале выполните:
ollama -vВерсия может отличаться от примеров в статьях. Важно, чтобы система находила команду. Сообщение о недоступном сервере при найденном CLI означает другой этап проблемы: запустите приложение или сервис. Сообщение «команда не найдена» относится к установке или пути поиска команды.
Не пытайтесь исправлять оба случая одинаково. В первом программа уже находится, но ей не к чему подключиться. Во втором терминал пока не знает, где она установлена. Это различие экономит повторные загрузки установщика.
Скачайте один конкретный локальный тег
Выполните команду и дождитесь успешного окончания:
ollama pull qwen3:0.6bpull скачивает модель. Пока идёт загрузка, сохраняйте соединение. Если она прервалась, повторите команду при восстановленной сети и дождитесь завершения. После этого проверьте, что модель появилась в локальном списке:
ollama lsВ списке должен присутствовать выбранный тег. Если его нет, переходить к проверке без сети рано. Обозначения pull, ls и run описаны в CLI reference.
Используйте полное имя из примера. Команда с другим тегом может скачать другой артефакт с другими требованиями. Слово «Qwen» или «Gemma» обозначает семейство, внутри которого могут быть очень разные модели.
Для первого опыта мы намеренно разделили загрузку и запуск. ollama run тоже может получить недостающие файлы, но тогда сложнее понять, что происходит после нажатия Enter: скачивание, загрузка в память или уже генерация ответа.
Получите первый ответ на коротком тексте
Запустите модель:
ollama run qwen3:0.6bПосле появления приглашения чата отправьте этот текст:
Прочитай заметку: встреча 12 ноября в 10:00, комната 7.
Нужно подготовить три слайда.
Выпиши дату, время, место и задачу. Не добавляй новых сведений.
Такой запрос удобнее первого вопроса о мировой политике. Все исходные факты уже перед вами, поэтому результат легко проверить. Модель должна сохранить 12 ноября, 10:00, комнату 7 и три слайда. Если она ошиблась, это наблюдение о данном ответе и конфигурации. Оно не означает, что установка сломана.
Не оценивайте весь локальный ИИ по одной компактной модели. Сейчас цель скромнее: пройти путь от файлов на диске до нового ответа. Качество подбирают следующим шагом, сравнивая несколько подходящих моделей на своих реальных заданиях.
Если текст идёт медленно, дайте модели закончить короткий ответ. Не увеличивайте одновременно длину запроса, размер модели и контекст: тогда вы потеряете исходную точку для сравнения.
Проверьте новый ответ после отключения сети
Для проверки используйте уже загруженную qwen3:0.6b, а не облачный вариант. Ollama поддерживает отдельный облачный режим, которому требуется соединение. Наличие установленного приложения не меняет место выполнения облачной модели.
- Завершите текущий чат командой
/bye. - Отключите Wi-Fi и проводное соединение либо временно отключите активные сетевые интерфейсы привычным способом своей ОС.
- Снова выполните
ollama run qwen3:0.6b. - Отправьте новый вопрос со свежим текстом, например: «Встреча перенесена на 13 ноября, 11:30, комнату 9. Выпиши новые параметры».
- Убедитесь, что пришёл новый ответ с изменёнными данными, затем верните соединение.
Ответ без подключения подтверждает, что этот разговор может выполняться автономно. Он не доказывает отсутствие любых сетевых обращений программы в остальных сценариях. Работа облака, поиск и внешние инструменты требуют отдельной проверки. Общий принцип разобран в статье об ИИ без интернета.
Для чистоты первого опыта достаточно обычного CLI-чата. Подключение браузерных расширений, агентов и сторонних сервисов добавьте позже, когда уже понятно, как выглядит работающая локальная цепочка.
Если что-то пошло не так, найдите этап
Команда ollama не найдена
- Что проверить сначала: Завершена ли установка и открыт ли новый терминал
- Следующее действие: Перезапустить терминал; сверить путь команды с инструкцией ОС
CLI есть, сервер недоступен
- Что проверить сначала: Работает ли приложение или сервис Ollama
- Следующее действие: Открыть приложение; на Linux проверить сервис или отдельный ollama serve
Модель не находится без сети
- Что проверить сначала: Есть ли точный тег в ollama ls
- Следующее действие: Подключиться, закончить pull и повторить проверку
Загрузка не завершается
- Что проверить сначала: Соединение и свободное место
- Следующее действие: Восстановить сеть или место, повторить pull
Программа сообщает о нехватке памяти
- Что проверить сначала: Какая модель и какой контекст выбраны
- Следующее действие: Уменьшить нагрузку и выбрать менее требовательную модель
Ответ медленный
- Что проверить сначала: Используемое устройство вычислений и объём входа
- Следующее действие: Посмотреть ollama ps; проверить короткий запрос
Для диагностики загруженных моделей выполните в другом терминале:
ollama psКолонка Processor показывает распределение вычисления между CPU и GPU. Объяснение находится в FAQ Ollama. Значение CPU само по себе не означает неисправность: оно помогает понять, почему скорость отличается от чужого компьютера.
Если нужно обращаться за помощью, сохраните текст ошибки, версию Ollama, модель, ОС и параметры оборудования. Личную переписку и ключи доступа в такой отчёт включать не нужно. Расположение журналов и другие шаги описаны в Troubleshooting.
Закройте чат и освободите память
Команда /bye завершает интерактивный разговор. Чтобы остановить загруженную модель явно, используйте:
ollama stop qwen3:0.6bЭто полезно перед другой тяжёлой задачей на компьютере. Остановка модели и удаление скачанных файлов решают разные задачи; повторный запуск уже скачанного тега не требует заново получать веса, пока они сохранены локально.
Теперь запишите результат своей первой проверки: ОС, версия Ollama, точный тег, пример запроса и факт получения нового ответа без сети. В следующем опыте меняйте один параметр за раз. Сначала можно выбрать модель с лучшим качеством на нужном языке, затем добавить документ или API.
Официальный quickstart показывает и другой локальный пример, Gemma 4 E2B, с собственными рекомендациями по ресурсам. Проверьте их перед загрузкой. Название маленького варианта семейства не гарантирует маленькую загрузку или свободную память на вашем устройстве.
Если ваш следующий вопрос связан с чтением PDF и удобным интерфейсом, вернитесь к сравнению Ollama и LM Studio. Если нужен разговор на телефоне в поездке, посмотрите офлайн-приложения для Android.
Источники
Ещё вопросы по теме
Нужен ли API-ключ для этого примера?
Для выбранной локальной модели API-ключ не требуется. Облачные сервисы и их настройки относятся к отдельному сценарию.
Можно ли начать сразу без интернета?
Программа и файлы модели должны заранее попасть на компьютер. В этом руководстве они скачиваются при подключении, а автономный ответ проверяется после загрузки.
Почему в статье маленькая модель?
Qwen3 0.6B выбрана для первого технического запуска с небольшой загрузкой. Её качество ограничено. После проверки процесса подберите модель под реальные задачи и доступную память.
Нужна ли видеокарта?
Возможности ускорения зависят от оборудования и ОС. Некоторые модели можно выполнять на CPU, но скорость и требования различаются. Для конкретной конфигурации сверяйтесь с документацией и проверяйте короткий запрос.
Что означает localhost:11434?
Это адрес локального сервера Ollama на вашем компьютере. Само обращение к localhost не определяет место выполнения выбранной модели: локальные и облачные сценарии нужно различать отдельно.